Luka MCA Lab 구축기 | 구축 전 환경 점검과 상태 기록
안녕하세요, 루카입니다. 오늘은 가상 학원 Luka MCA Lab의 구축을 시작하기 전에 지금 org 상태를 기록해 보겠습니다.
이번 단계에서는 무엇부터 만들지 정하고, 구축 전 org 상태를 기준선으로 남겨 둡니다.
기준선이 있으면 작업마다 무엇이 바뀌었는지 비교하고, 새 org에서 어디까지 다시 세워야 하는지 알 수 있습니다.
이런 독자에게: Marketing Cloud Next(MCN)가 켜진 org를 넘겨받아 구축을 시작하는 Salesforce 관리자와 컨설턴트에게 맞습니다. MCN을 켜는 순서는 003에, 이 프로젝트의 요건표는 PRJ-01에 있습니다. 이 글의 조회는 Marketing Cloud Admin 권한 집합이 있는 관리자 계정과 Salesforce CLI로 인증한 org에서 했습니다.
읽고 답할 수 있는 질문
- 시험 메일보다 먼저 해야 하는 일은 무엇인가요?
- 구축 전 org 상태를 무엇으로 남기나요?
- 작업 전후에 무엇이 바뀌었는지 어떻게 보나요?
완료 확인: 기준선 파일이 하나 생기고, 그 안에서 "통합 개인 0명"처럼 다음에 채울 항목을 하나 이상 짚을 수 있으면 끝납니다.
구축 순서
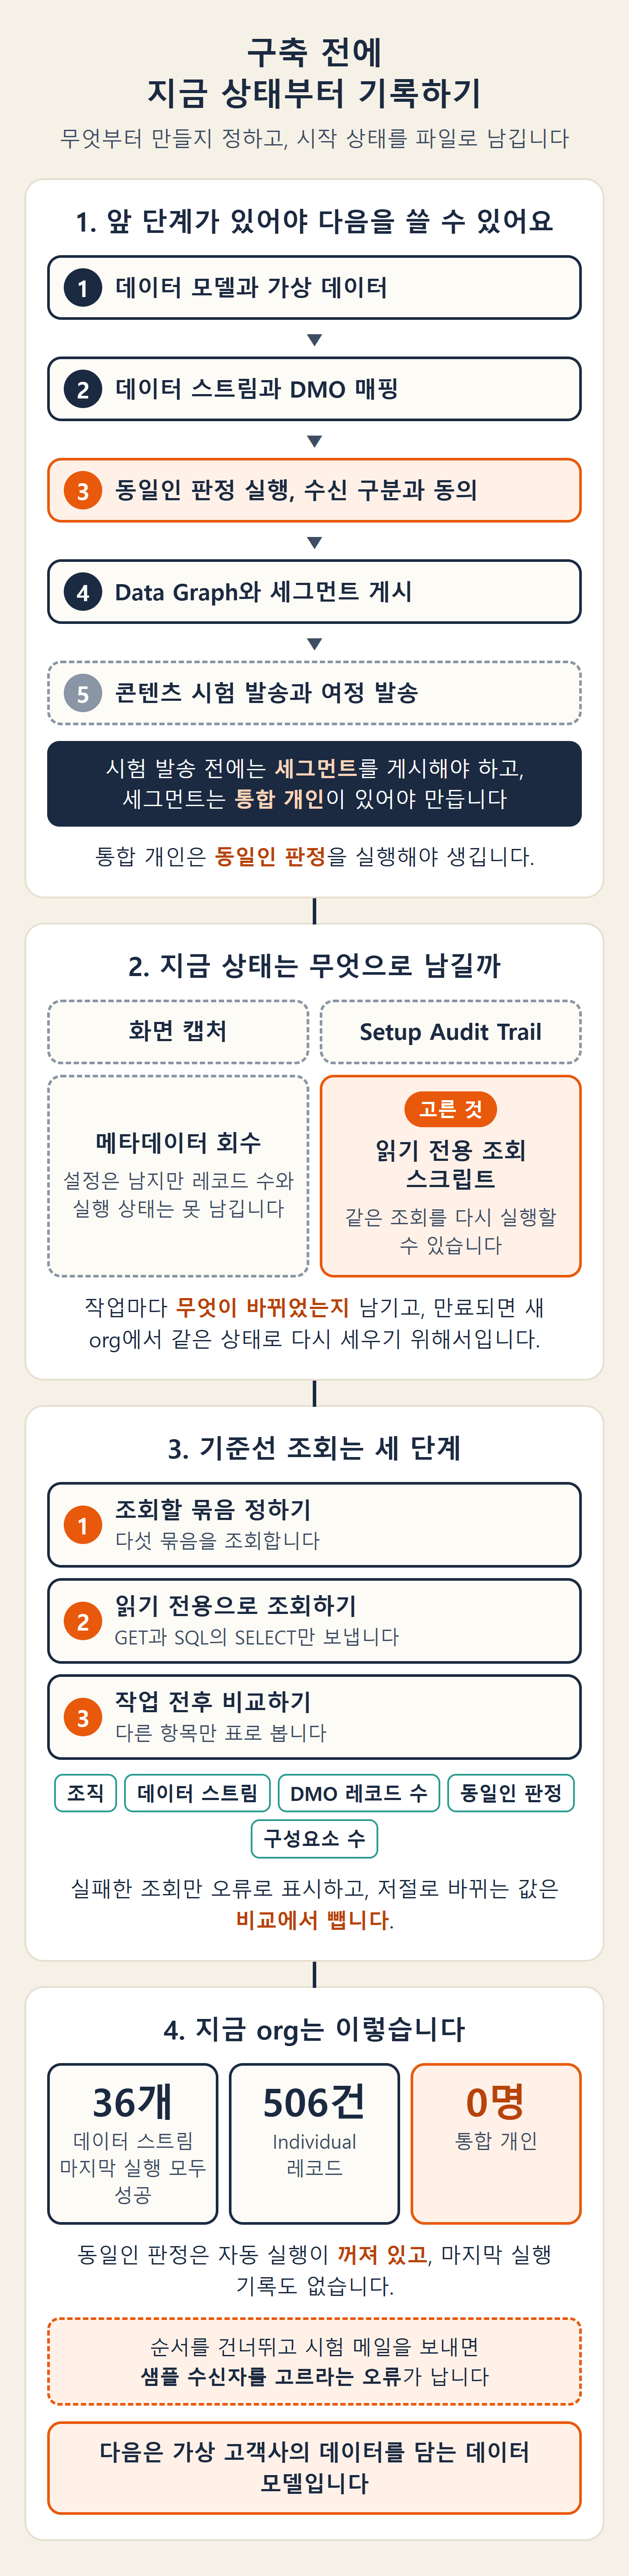
세그먼트와 시험 발송은 통합 개인이 있어야 쓸 수 있으므로, 데이터 모델과 동일인 판정을 그보다 먼저 둡니다.
MCN의 기능 문서는 저마다 전제 조건을 적습니다. 세그먼트는 통합 개인(Unified Individual) 위에서 만들고, 미리보기와 시험 발송 전에는 세그먼트를 하나 이상 게시해야 합니다. 통합 개인은 동일인 판정(Identity Resolution)을 실행해야 생깁니다.
이 전제들을 바탕으로 정한 순서는 아래와 같습니다.
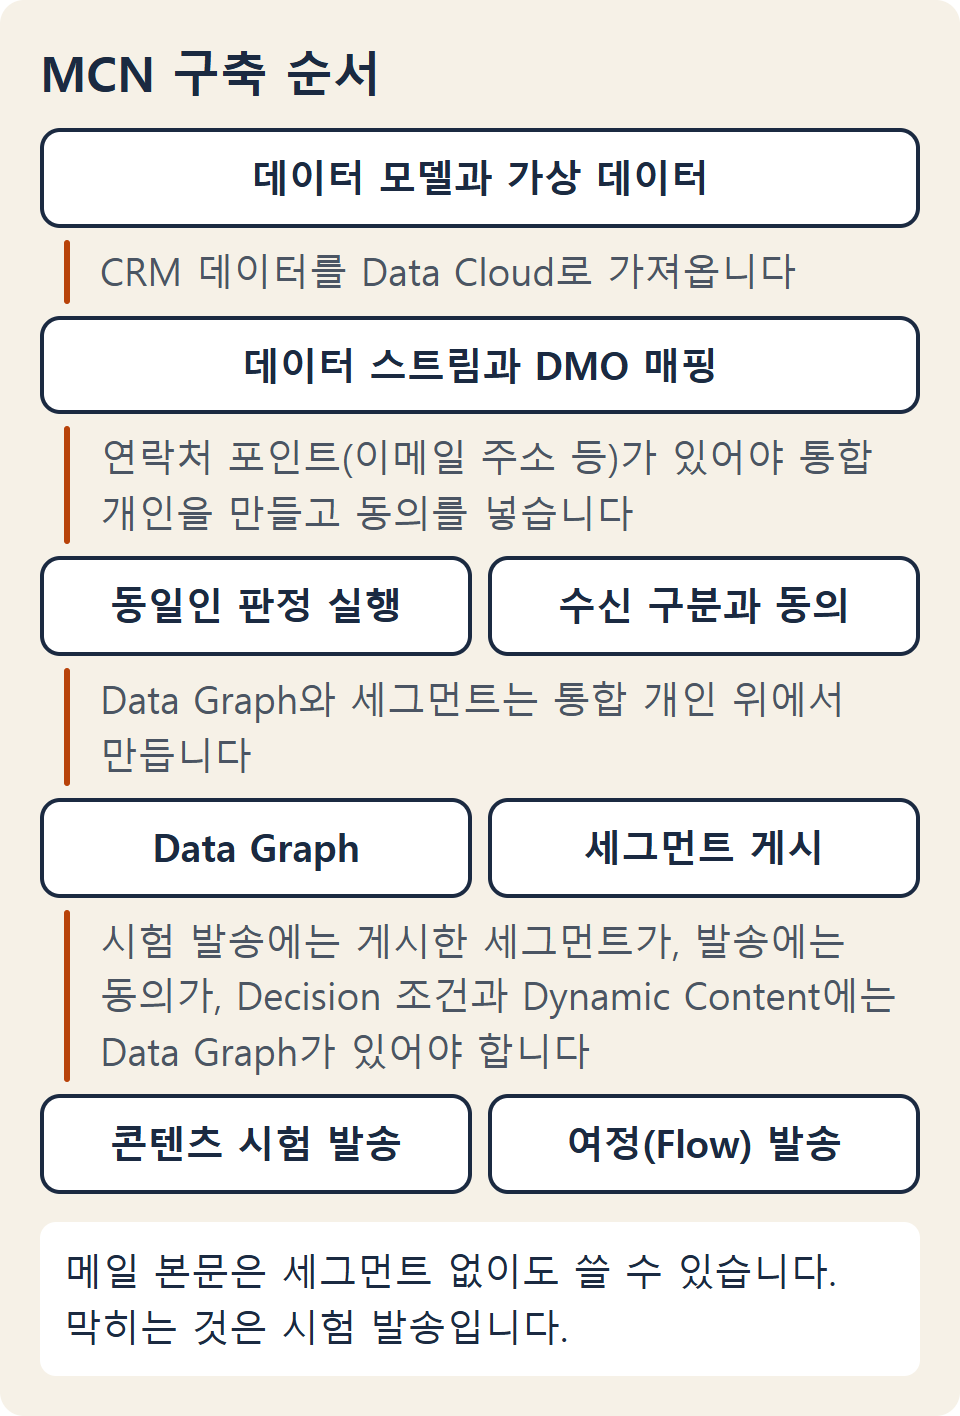
- 동의: 동의는 이메일 주소 같은 연락처 포인트(Contact Point)에 묶이므로, 연락처 포인트를 가져온 뒤에 넣습니다. 동의가 없는 주소로 Flow가 보낸 홍보 메일은 NOT_SENT로 끝납니다(007).
- Data Graph: Data Graph는 Unified Individual을 기준으로 만듭니다. Flow의 Decision에서 사람별 속성을 조건으로 쓰려면 Data Graph를 먼저 고릅니다(005). 이메일의 Dynamic Content도 Data Graph를 추가해야 쓸 수 있습니다(009).
- 콘텐츠: 세그먼트와 통합 개인이 없어도 메일 본문은 쓸 수 있습니다. 막히는 것은 시험 발송입니다.
기록 방법
구축 전 org 상태는 같은 조회를 다시 실행할 수 있는 읽기 전용 스크립트로 남깁니다.
이 org는 제가 만드는 MCN 확장 제품의 설치 시험과 함께 쓰는 체험판입니다. 그래서 작업마다 무엇이 바뀌었는지 남겨야 하고, 만료되면 새 org에서 같은 상태로 다시 세워야 합니다.
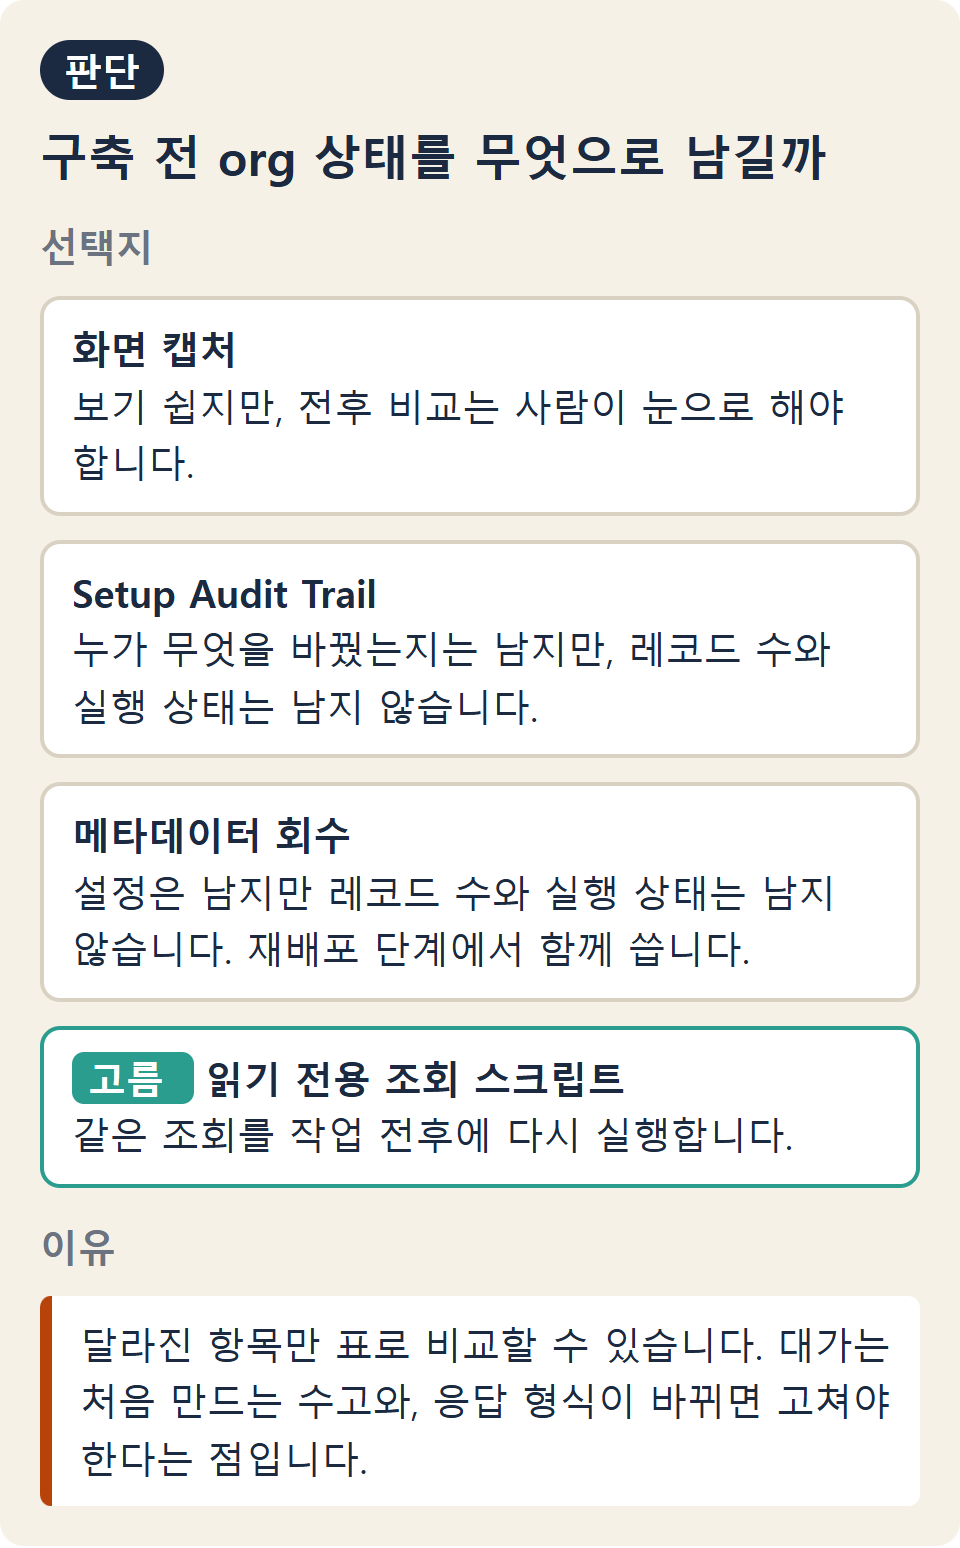
메타데이터 회수는 설정을 남기지만 레코드 수와 실행 상태는 남기지 못합니다. 그래서 상태 기록에는 조회 스크립트를 쓰고, 메타데이터는 다시 배포하는 단계에서 함께 씁니다.
기준선 조회
같은 조회를 작업 전후에 실행해, 달라진 항목만 비교합니다.
1. 조회할 묶음 정하기
다섯 묶음을 조회합니다.
- 조직: 종류와 체험판 만료일
- 데이터 스트림: 스트림마다 마지막 실행 상태
- DMO 레코드 수: Data Cloud의 데이터 모델 오브젝트(DMO)에 든 Individual, 통합 개인, 수신 동의 등의 수
- 동일인 판정: 규칙 집합(Ruleset)의 상태, 자동 실행 여부, 마지막 실행
- 구성요소 수: Data Graph, Calculated Insight, 수신 구분, 그리고 이름 앞에
LUKA_를 붙여 직접 만든 구성요소
2. 읽기 전용으로 조회하기
조회 요청(GET과 SQL의 SELECT)만 보냅니다. 동일인 판정 규칙 집합은 REST API로 읽습니다.
GET {base}/ssot/identity-resolutions여기서 {base}는 인스턴스 주소 뒤의 /services/data/v67.0 경로입니다. DMO 레코드 수는 Data Cloud의 SQL로 셉니다. 같은 SQL을 Data Cloud의 Query Editor에서도 실행할 수 있습니다.
SELECT COUNT(*) AS n
FROM UnifiedIndividual__dlm
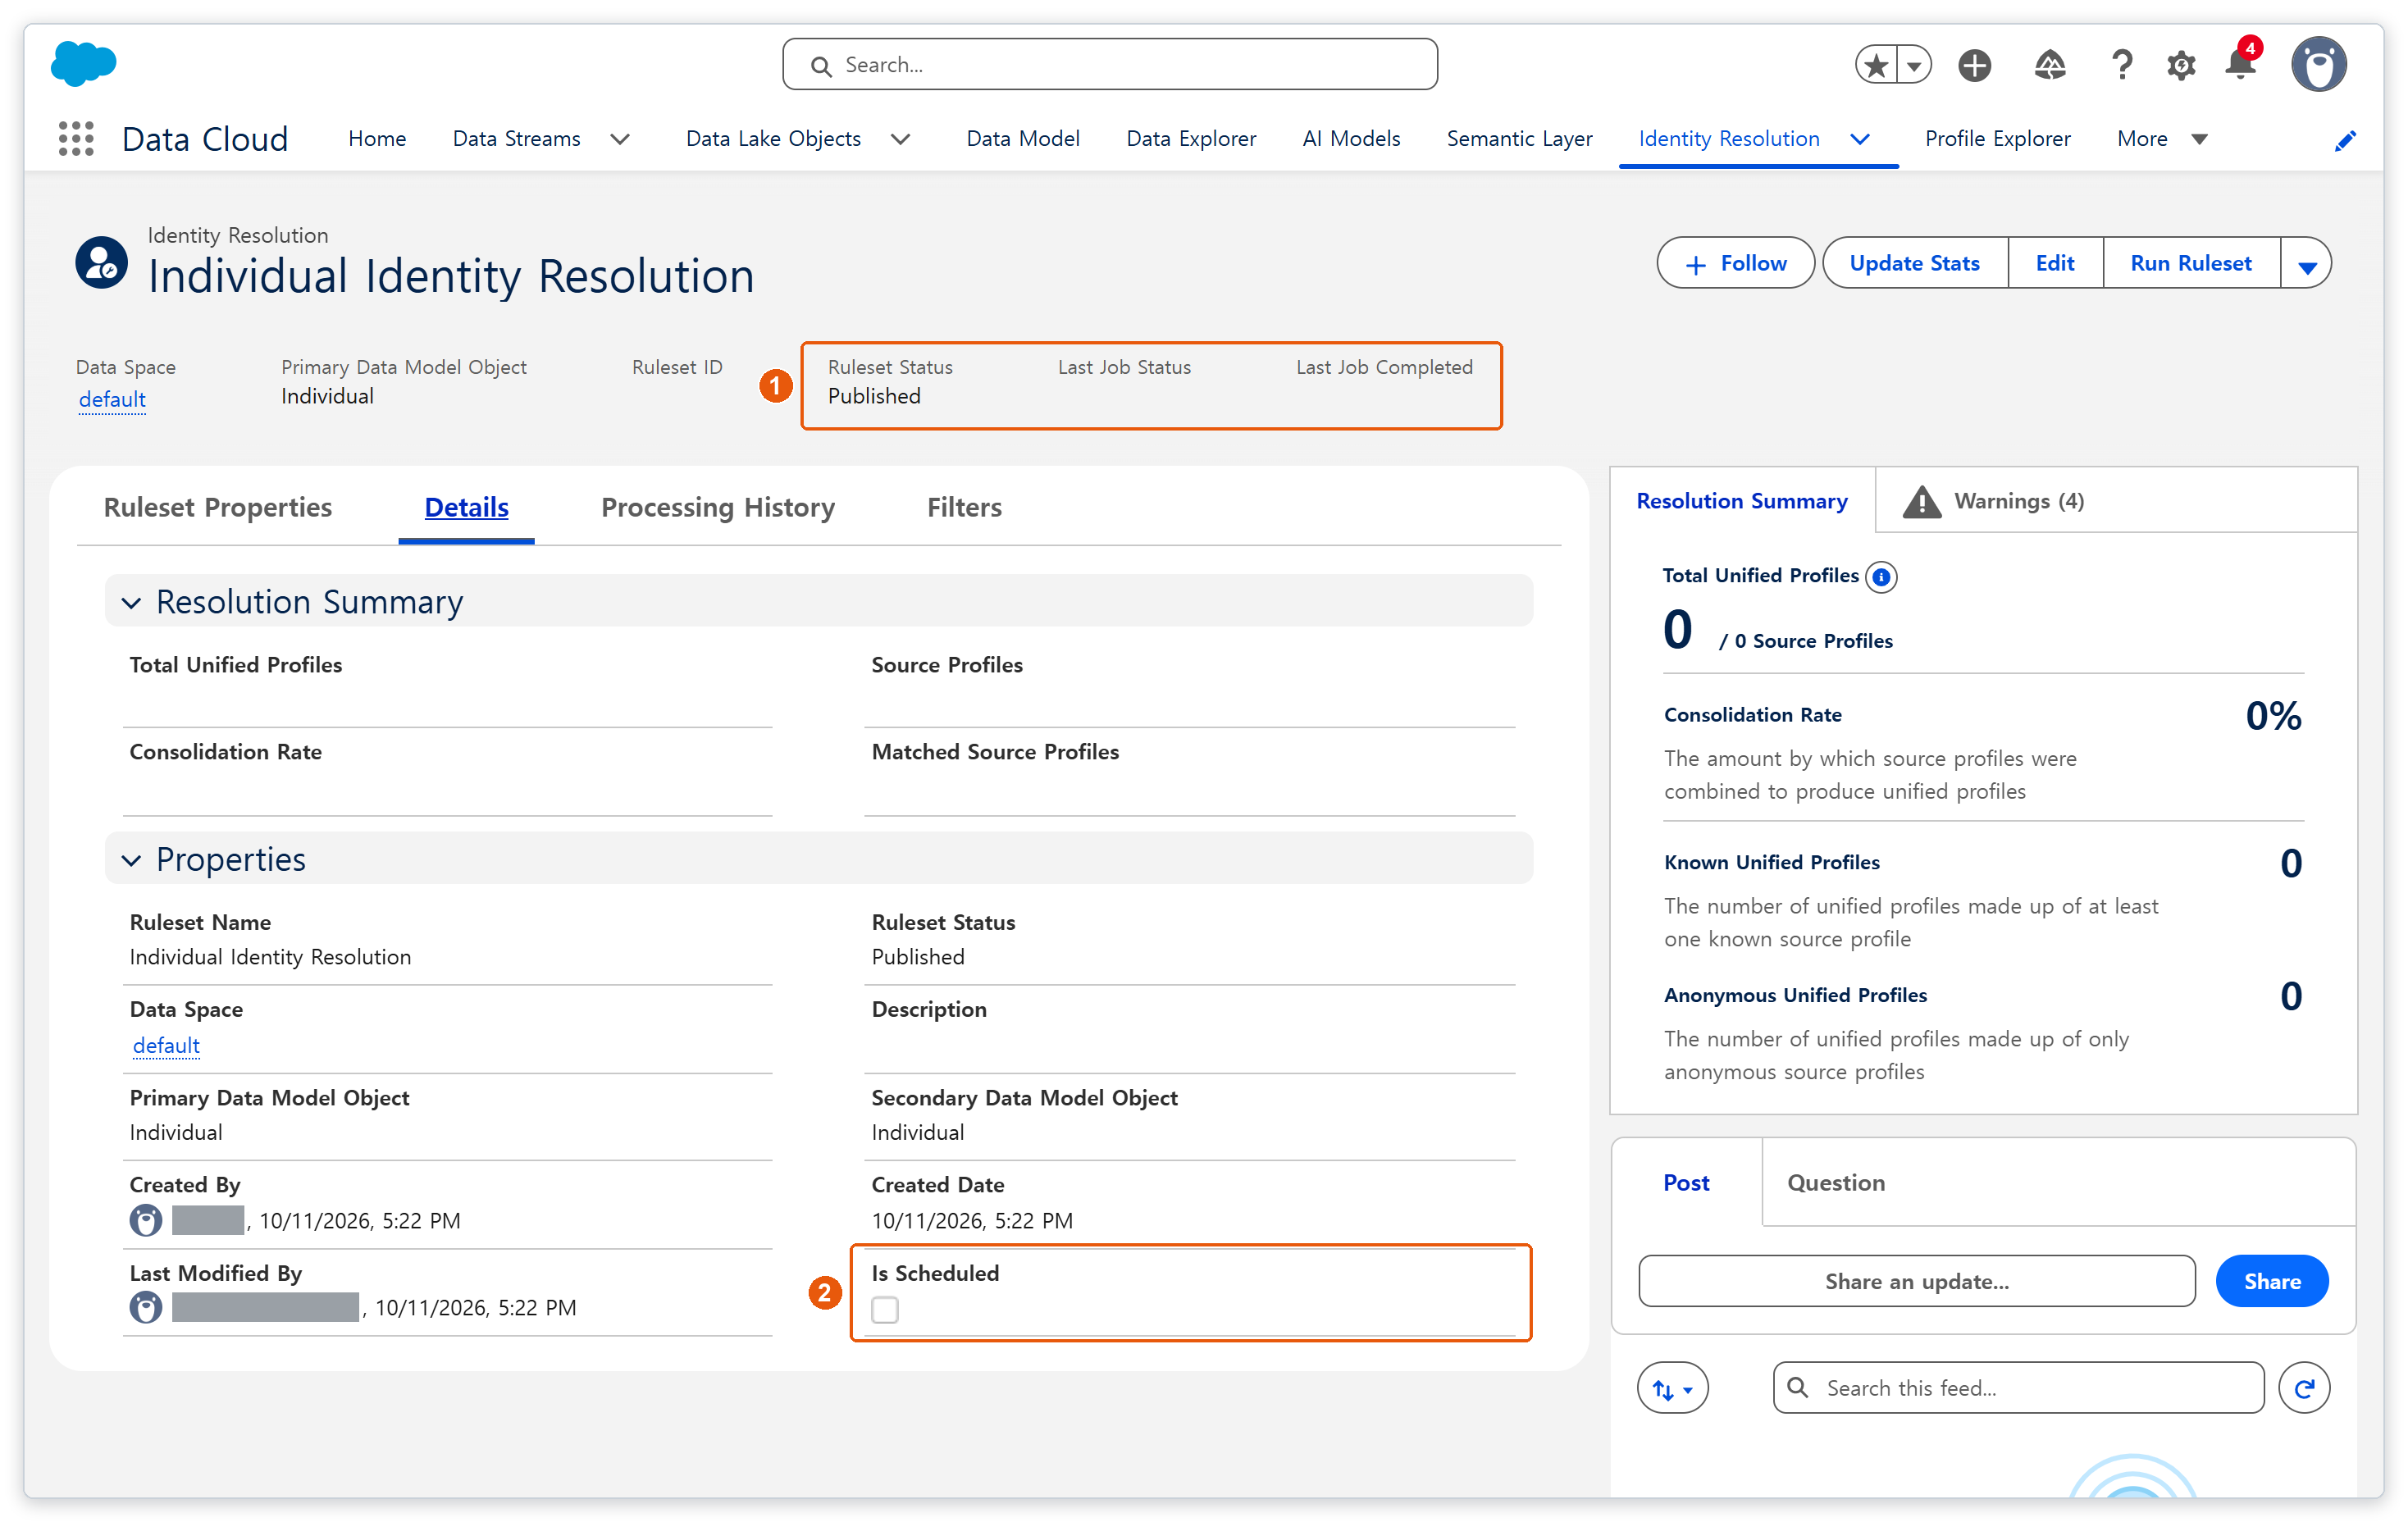
이 org에서 스크립트가 읽은 값은 화면의 값과 같았습니다. Data Cloud 앱의 Data Streams 목록에서는 Last Run Status 열이 마지막 실행 상태입니다.

동일인 판정 규칙 집합의 상세 화면에서는 Last Job Status와 Last Job Completed가 마지막 실행입니다. Details 탭의 Is Scheduled가 자동 실행 여부입니다. 실행 전이라 오른쪽 요약의 Total Unified Profiles도 0입니다.
3. 작업 전후 비교하기
작업을 시작할 때와 끝낼 때 같은 조회를 실행하고, 두 결과에서 다른 항목만 봅니다. 준비물은 Salesforce CLI(sf)로 로그인한 org와 Python 3이고, 스크립트는 아래 접기에 있습니다.
python snapshot.py --org <별칭>
python snapshot.py --compare <앞> <뒤>
첫 줄은 작업 전과 후에 한 번씩 실행하며, 실행할 때마다 snapshot-<날짜>-<시각>.json 파일이 생깁니다. 둘째 줄에 그 두 파일을 넣으면 차이가 세 가지로 나옵니다.
- 추가된 항목: 뒤 파일에만 있는 항목입니다. 조회 항목을 늘렸거나 새 데이터 스트림이 생기면 여기에 나오므로, 작업 결과로 읽기 전에 어느 쪽인지 봅니다.
- 사라진 항목: 앞 파일에만 있는 항목입니다.
- 값이 바뀐 항목: 양쪽에 있고 값이 다른 항목입니다. 작업이 실제로 바꾼 것은 여기서 봅니다.
직접 만든 구성요소의 이름 접두어가 다르면 --prefix로 바꿉니다. 스크립트에는 설계 판단 둘을 넣었습니다.
- 실패한 조회만 표시: 조회 하나가 실패해도 그 항목만 오류로 남기고 나머지는 계속 조회합니다.
- 저절로 바뀌는 값 제외: 마지막 갱신 시각처럼 저절로 바뀌는 값은 비교에서 뺍니다.
| 묶음 | 조회하는 곳 | 읽는 값 |
|---|---|---|
| 조직 | SOQL의 Organization | 종류, 만료일 |
| 데이터 스트림 | Data Cloud REST API | 마지막 실행 상태, 레코드 수 |
| DMO 레코드 수 | Data Cloud SQL | COUNT(*) |
| 동일인 판정 | REST API(위의 GET) | 상태, 자동 실행, 마지막 실행 |
| 구성요소 수 | SOQL과 Data Cloud REST API | Data Graph, Calculated Insight, 수신 구분의 수와 이름이 LUKA_로 시작하는 Flow, 콘텐츠, 세그먼트의 수 |
결과는 조회할 때마다 JSON 파일 하나로 남깁니다.
"""
@description  org 기준선 조회(읽기 전용).
  GET 과 SELECT 만 쓰고 결과를 JSON
  파일로 저장한다. --compare 는 두
  파일에서 추가, 사라짐, 바뀐 값을
  나눠 찍는다.
@author       Luka
@created      2026-10-15
@log          2026-10-15
"""
import argparse
import json
import os
import shutil
import subprocess
import sys
import time
import urllib.request as rq
from urllib.parse import quote

V = "67.0"  # 관찰한 API 버전
DMOS = [
  "ssot__Individual__dlm",
  "ssot__ContactPointEmail__dlm",
  "ssot__CommunicationSubscriptionConsent__dlm",
  "UnifiedIndividual__dlm",
  "IndividualIdentityLink__dlm",
]
IR_KEYS = ("rulesetStatus",
  "doesRunAutomatically",
  "lastJobStatus",
  "lastJobCompleted",
  "totalUnifiedProfiles")
SKIP = ("taken_at",)
SKIP_END = (".lastRefreshDate",)


def sf(org, *args):
  cmd = [shutil.which("sf"), *args]
  cmd += ["--json"]
  if org:
    cmd += ["--target-org", org]
  out = subprocess.run(cmd,
    capture_output=True, text=True,
    encoding="utf-8").stdout
  r = json.loads(out[out.index("{"):])
  if r.get("status"):
    sys.exit(r.get("message"))
  return r["result"]


def login(org):
  # org display 의 토큰은 만료될 수
  # 있어 새 토큰은 따로 받는다
  host = sf(org, "org", "display")
  tok = sf(org, "org", "auth",
    "show-access-token")
  return (host["instanceUrl"],
    tok["accessToken"])


def connect(org):
  host, token = login(org)

  def call(path, body=None):
    if body:  # POST 는 SQL 조회 하나뿐
      assert body["sql"].startswith(
        "SELECT")
      body = json.dumps(body).encode()
    req = rq.Request(
      f"{host}/services/data/v{V}"
      + path, data=body,
      headers={"Authorization":
        "Bearer " + token,
        "Content-Type":
        "application/json"})
    with rq.urlopen(req) as r:
      return json.load(r)

  return call


def safe(fn):
  try:
    return fn()
  except Exception as e:
    return {"error": str(e)[:150]}


def take(call, p):
  def soql(q, tooling=""):
    return call(f"{tooling}/query?q="
      + quote(q))["totalSize"]

  def like(obj, col, tooling=""):
    q = f"SELECT COUNT() FROM {obj}"
    q += f" WHERE {col} LIKE '"
    q += p.replace("_", r"\_") + "%'"
    return soql(q, tooling)

  def org():
    r = call("/query?q=" + quote(
      "SELECT OrganizationType,"
      " IsSandbox,"
      " TrialExpirationDate"
      " FROM Organization"))
    r = r["records"][0]
    r.pop("attributes")
    return r

  def streams():
    d = call("/ssot/data-streams"
      "?limit=200")["dataStreams"]
    keys = ("lastRunStatus",
      "totalRecords",
      "lastRefreshDate")
    return {s["name"]:
      {k: s.get(k) for k in keys}
      for s in d}

  def sql(t):
    q = f"SELECT COUNT(*) FROM {t}"
    d = call("/ssot/query-sql",
      {"sql": q})
    return d["data"][0][0]

  def ident():
    d = call("/ssot/"
      "identity-resolutions")
    d = d["identityResolutions"]
    return {i.get("label") or i["id"]:
      {k: i.get(k) for k in IR_KEYS}
      for i in d}

  def graphs():
    d = call("/ssot/data-graphs"
      "/metadata")
    return len(d["dataGraphMetadata"])

  def insights():
    d = call("/ssot/calculated-"
      "insights")
    return d["collection"]["total"]

  def segments():
    d = call("/ssot/segments"
      "?batchSize=200")["segments"]
    return sum(1 for s in d
      if (s.get("apiName") or "")
      .startswith(p))

  return {
    "taken_at": time.strftime(
      "%Y-%m-%d %H:%M:%S"),
    "organization": safe(org),
    "data_streams": safe(streams),
    "dmo_rows": {t: safe(
      lambda t=t: sql(t))
      for t in DMOS},
    "identity_resolution":
      safe(ident),
    "counts": {
      "data_graphs": safe(graphs),
      "calculated_insights":
        safe(insights),
      "subscriptions": safe(
        lambda: soql("SELECT COUNT()"
        " FROM CommSubscription")),
    },
    "custom": {
      "flows": safe(lambda: like(
        "FlowDefinition",
        "DeveloperName", "/tooling")),
      "contents": safe(lambda: like(
        "ManagedContentVariant",
        "Name")),
      "segments": safe(segments),
    },
  }


def flat(o, p=""):
  if not isinstance(o, dict):
    return {p: o}
  out = {}
  for k, v in o.items():
    q = p + "." + k if p else k
    out.update(flat(v, q))
  return out


def compare(a, b):
  fa, fb = (flat(json.load(
    open(f, encoding="utf-8")))
    for f in (a, b))
  keys = [k for k in sorted(fa | fb)
    if k not in SKIP
    and not k.endswith(SKIP_END)]
  new = [k for k in keys
    if k not in fa]
  gone = [k for k in keys
    if k not in fb]
  diff = [k for k in keys
    if k in fa and k in fb
    and fa[k] != fb[k]]
  print(f"추가된 항목 {len(new)}건")
  for k in new:
    print(f"  {k} = {fb[k]}")
  print(f"사라진 항목 {len(gone)}건")
  for k in gone:
    print(f"  {k} = {fa[k]}")
  print(f"값이 바뀐 항목 {len(diff)}건")
  for k in diff:
    print(f"  {k}:",
      fa[k], "->", fb[k])


def main():
  ap = argparse.ArgumentParser()
  ap.add_argument("--org",
    default=os.environ.get("SF_ORG"))
  ap.add_argument("--prefix",
    default="LUKA_")
  ap.add_argument("--out", default=
    time.strftime(
    "snapshot-%Y%m%d-%H%M%S.json"))
  ap.add_argument("--compare",
    nargs=2)
  a = ap.parse_args()
  if a.compare:
    return compare(*a.compare)
  s = take(connect(a.org), a.prefix)
  with open(a.out, "w",
      encoding="utf-8") as f:
    json.dump(s, f, indent=1,
      ensure_ascii=False)
  print("스트림", len(s["data_streams"]))
  for k in ("organization",
      "dmo_rows", "counts", "custom",
      "identity_resolution"):
    print(k, s[k])
  err = [k for k in flat(s)
    if k.endswith("error")]
  print("저장:", a.out)
  if err:
    print("error 항목:", ", ".join(err))


if __name__ == "__main__":
main()첫 기준선(10:06)과 이 글을 시작할 때(11:36)의 조회를 비교한 결과를 두 가지로 나눴습니다. 그 사이에 시험 메일 콘텐츠를 하나 만들었습니다. 항목 이름은 줄여 적었으므로 스크립트 출력과 글자가 다를 수 있습니다.
값이 바뀐 항목: 두 조회에 모두 있고 값이 다른 항목입니다.
| 항목 | 10:06 | 11:36 |
|---|---|---|
| 직접 만든 콘텐츠 | 0 | 1 |
| 콘텐츠를 가져오는 스트림의 레코드 | 635 | 636 |
추가된 항목: 11:36에 조회 항목을 더해서 11:36 조회에만 있는 항목입니다.
| 항목 | 11:36 |
|---|---|
| Data Graph 수 | 0 |
| Calculated Insight 수 | 1 |
| 수신 구분 수 | 1 |
| 동일인 판정의 마지막 실행 | 기록 없음 |
지금 상태
지금 org는 데이터 스트림 36개의 마지막 실행이 모두 성공했지만 통합 개인이 0명이므로, 가상 고객사의 데이터를 넣은 뒤 동일인 판정을 실행해 통합 개인부터 만듭니다.
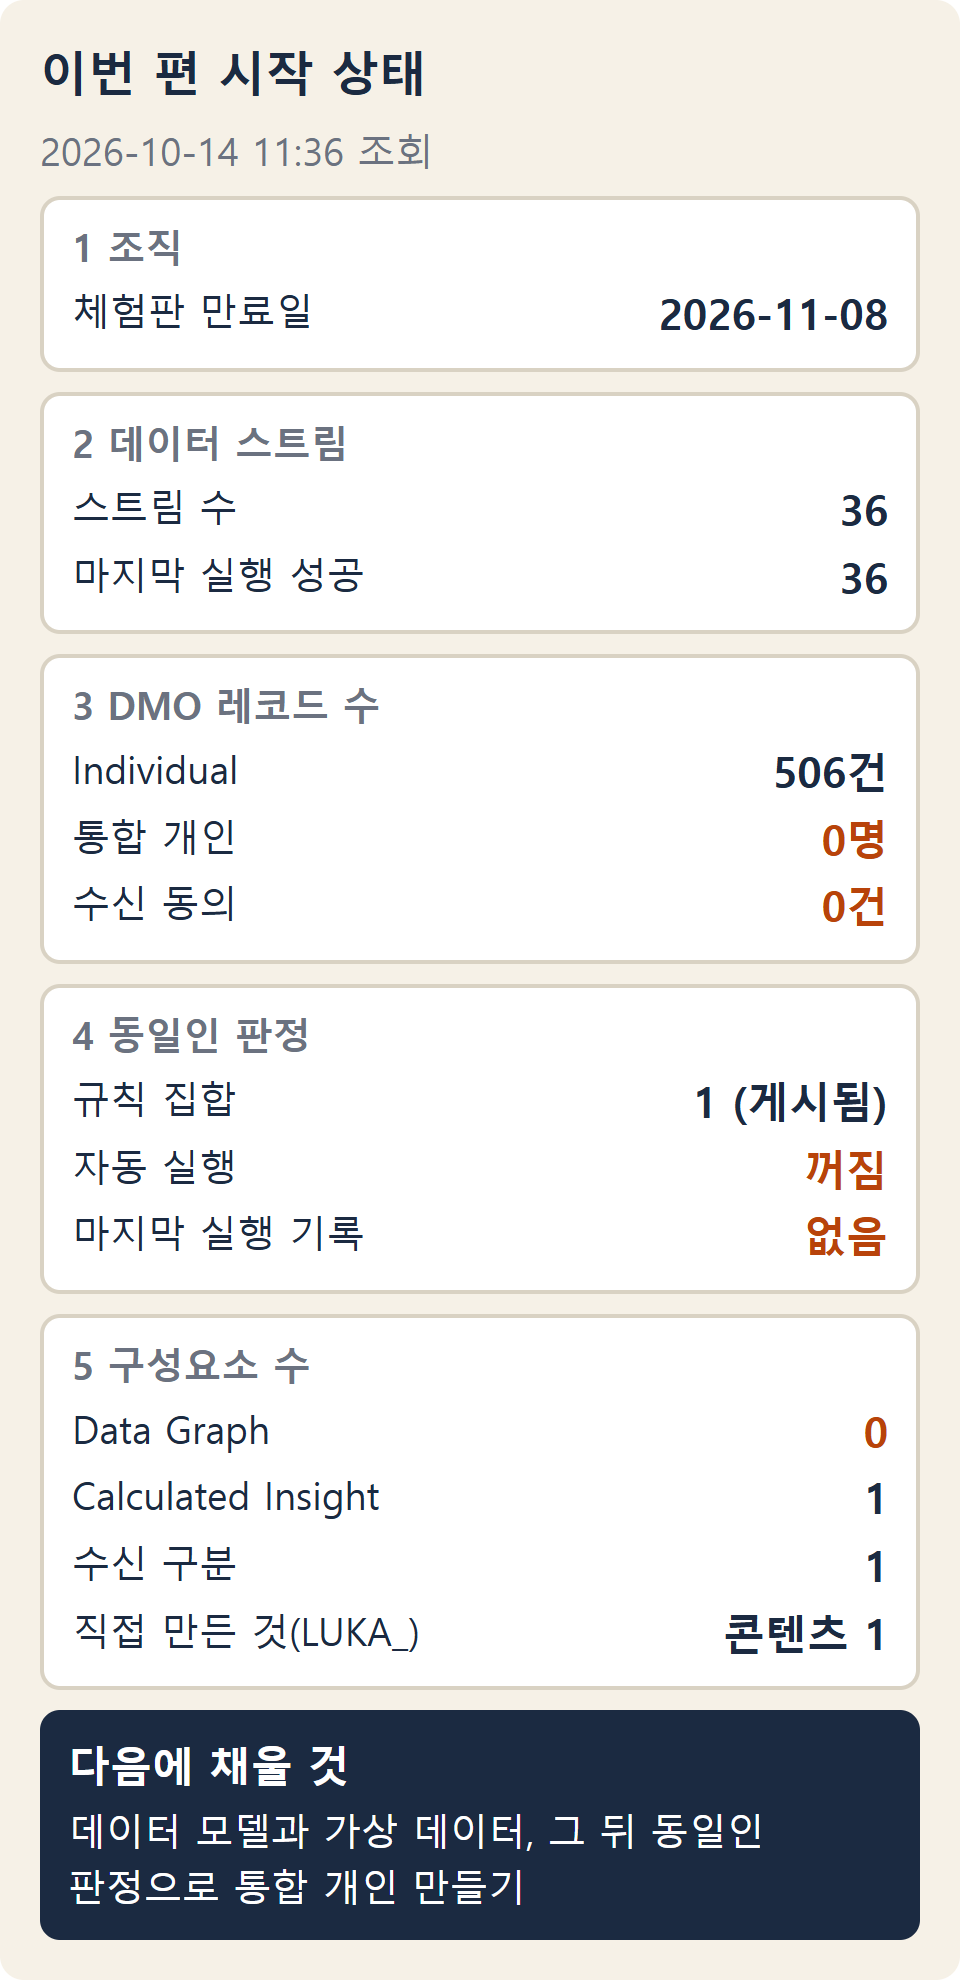
Individual 레코드는 506건인데 통합 개인은 0명입니다. 규칙 집합은 게시되어 있지만 자동 실행이 꺼져 있고, 마지막 실행 기록이 없습니다.
아래는 순서를 건너뛰면 생기는 일을 보인 실패 사례입니다. 시험 메일을 보내려 하면 샘플 수신자를 고르라는 오류가 납니다.
Preview 창에서 샘플 수신자를 고르는 방법은 두 가지입니다. 게시한 세그먼트에서 고르거나(Segment), 통합 개인 ID를 넣는 것(Profile)입니다. 이 org에는 아직 게시한 세그먼트가 없고 통합 개인도 0명이라 두 방법 모두 쓸 수 없습니다.
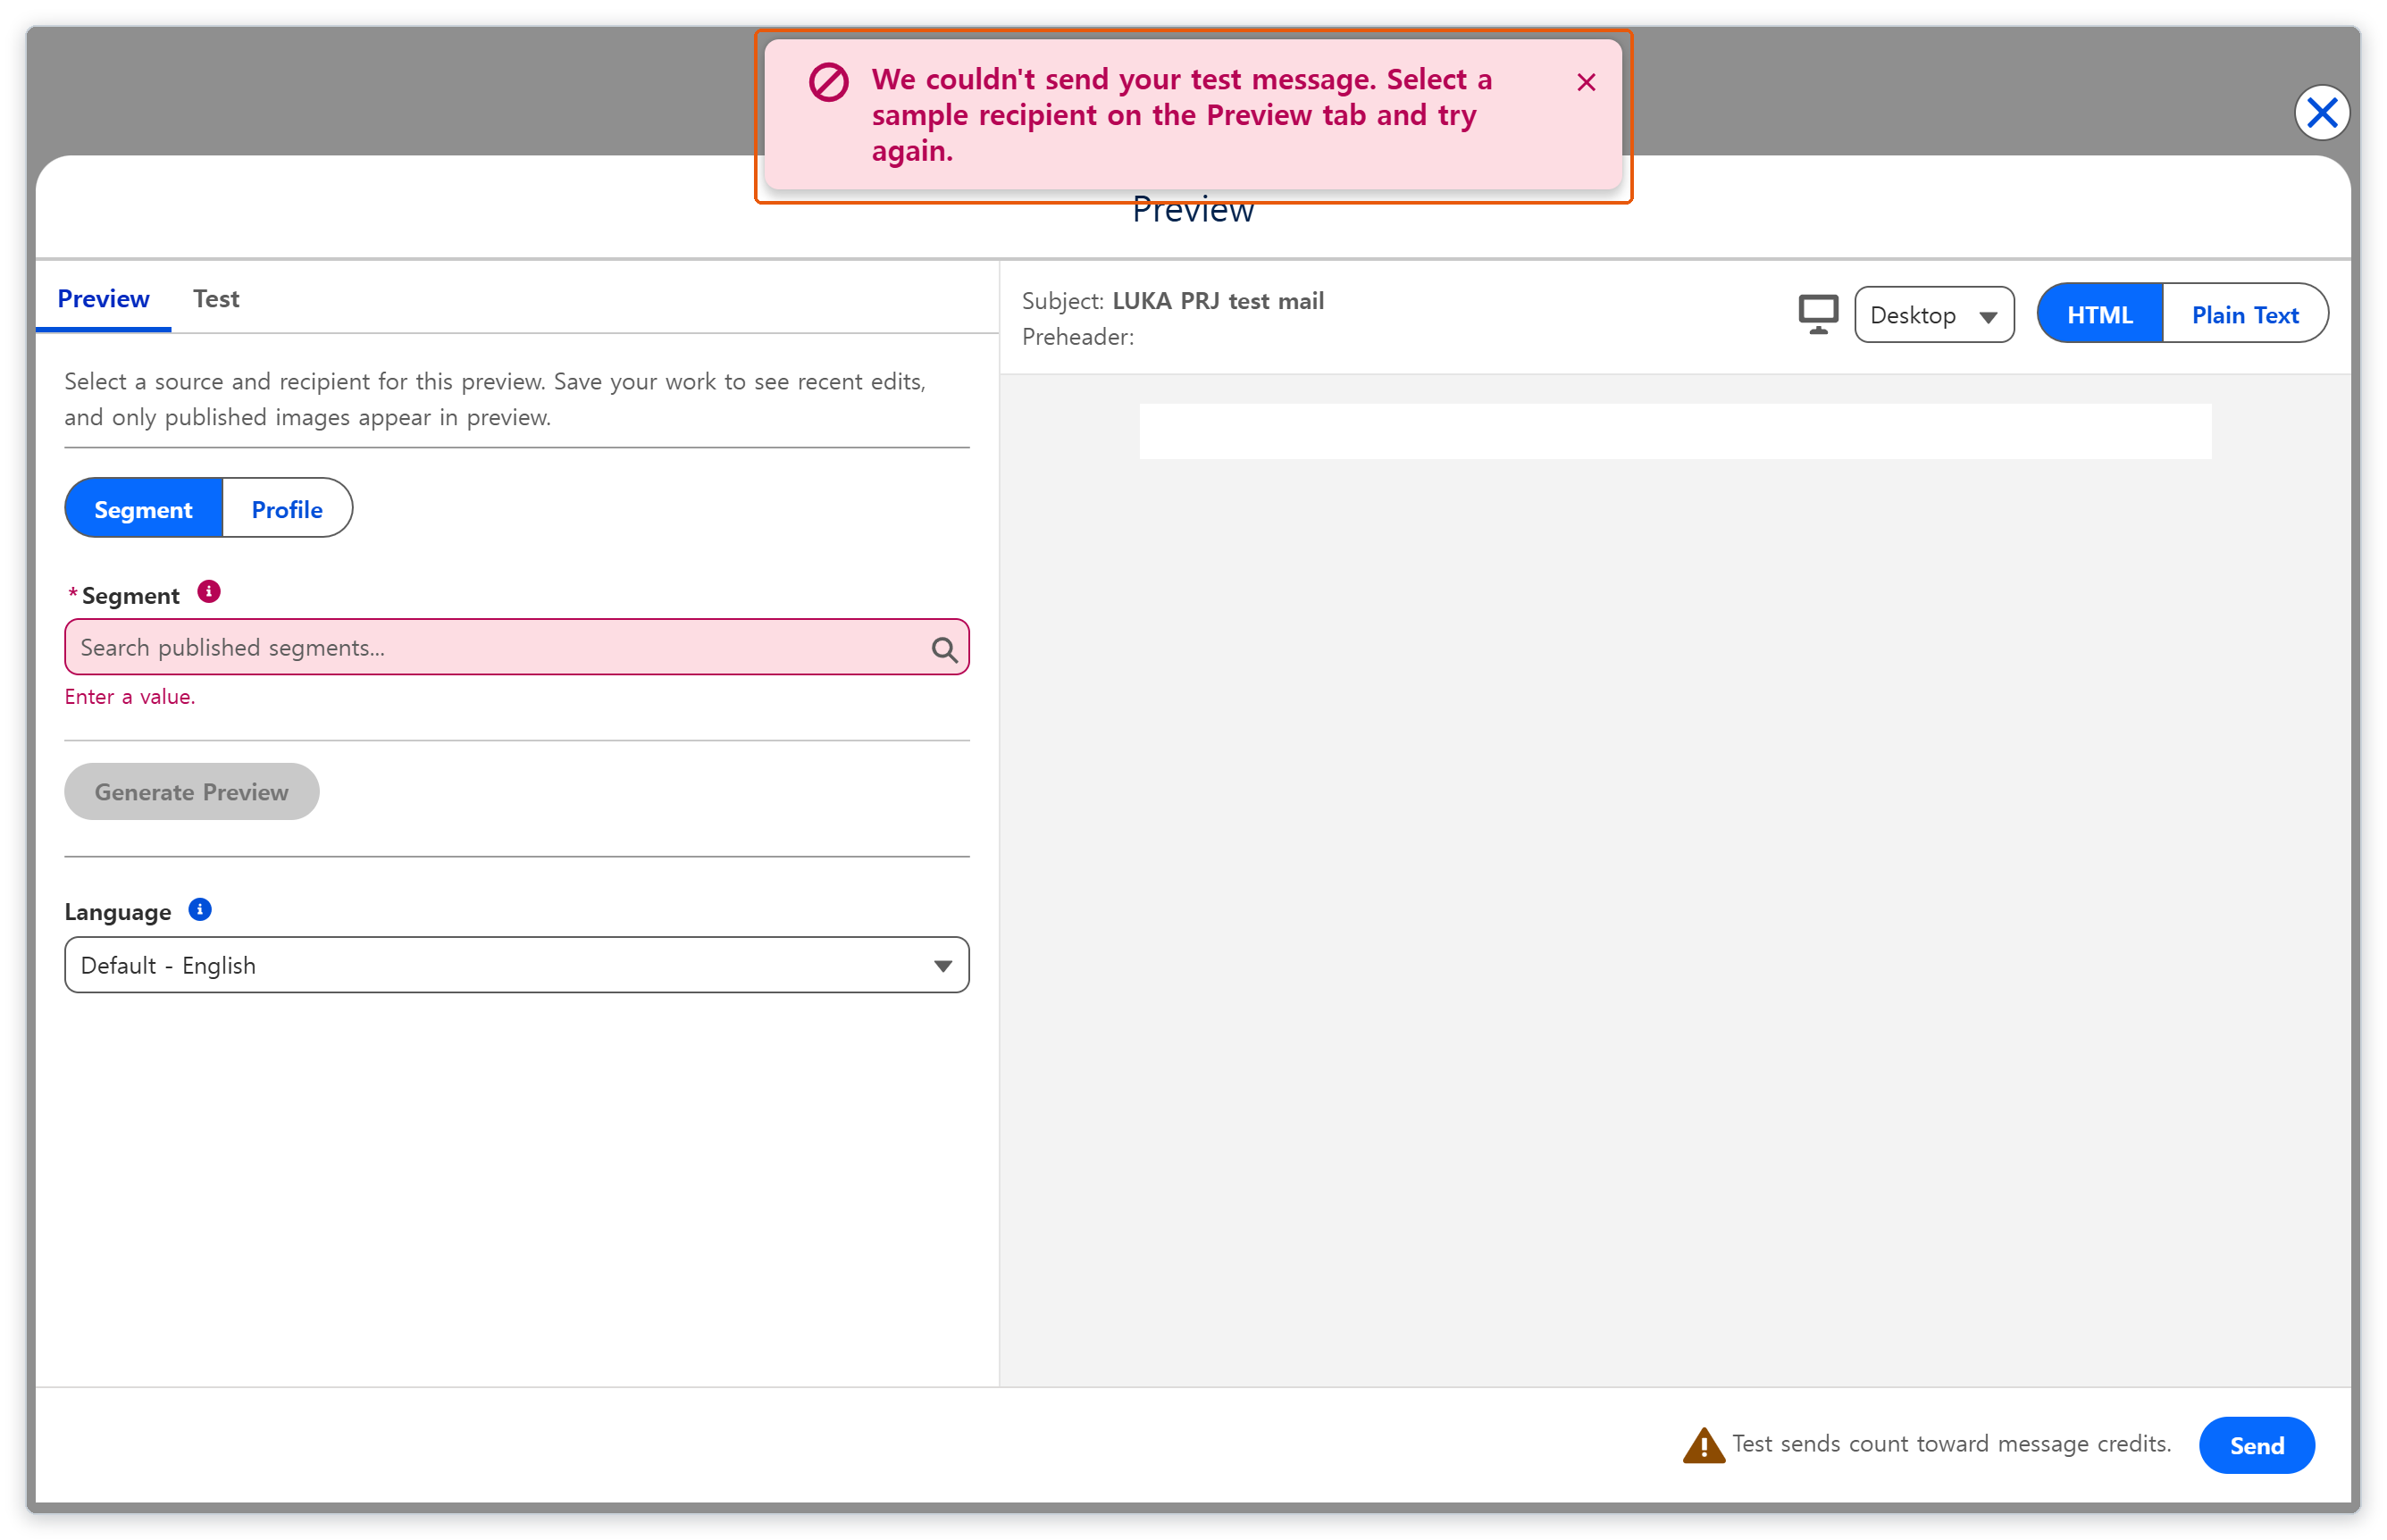
시험 발송 화면과 샘플 수신자를 고르는 방법은 008에 있습니다.
이 org에는 Salesforce가 시연용으로 넣어 둔 데이터(SDO)가 있어 지금 동일인 판정을 실행할 수도 있습니다. 그러나 동일인 판정 규칙 집합은 Data 360 크레딧을 쓰므로, 가상 고객사의 데이터를 넣은 뒤 한 번에 실행합니다.
그래서 다음 단계는 요건표의 데이터를 담는 데이터 모델입니다. 데이터 모델은 별도 글에서 다룰 예정입니다.
참고 문서
'프로젝트' 카테고리의 다른 글
| Luka MCA Lab 구축기 | Salesforce CLI로 오브젝트 배포와 가상 데이터 입력 (0) | 2026.10.15 |
|---|---|
| Luka MCA Lab 구축기 | 학원 데이터 모델과 오브젝트 설계 (0) | 2026.10.14 |
| Luka MCA Lab 구축기 | 마케팅 시나리오와 구축 요건 정의 (0) | 2026.10.14 |